Снимки экрана
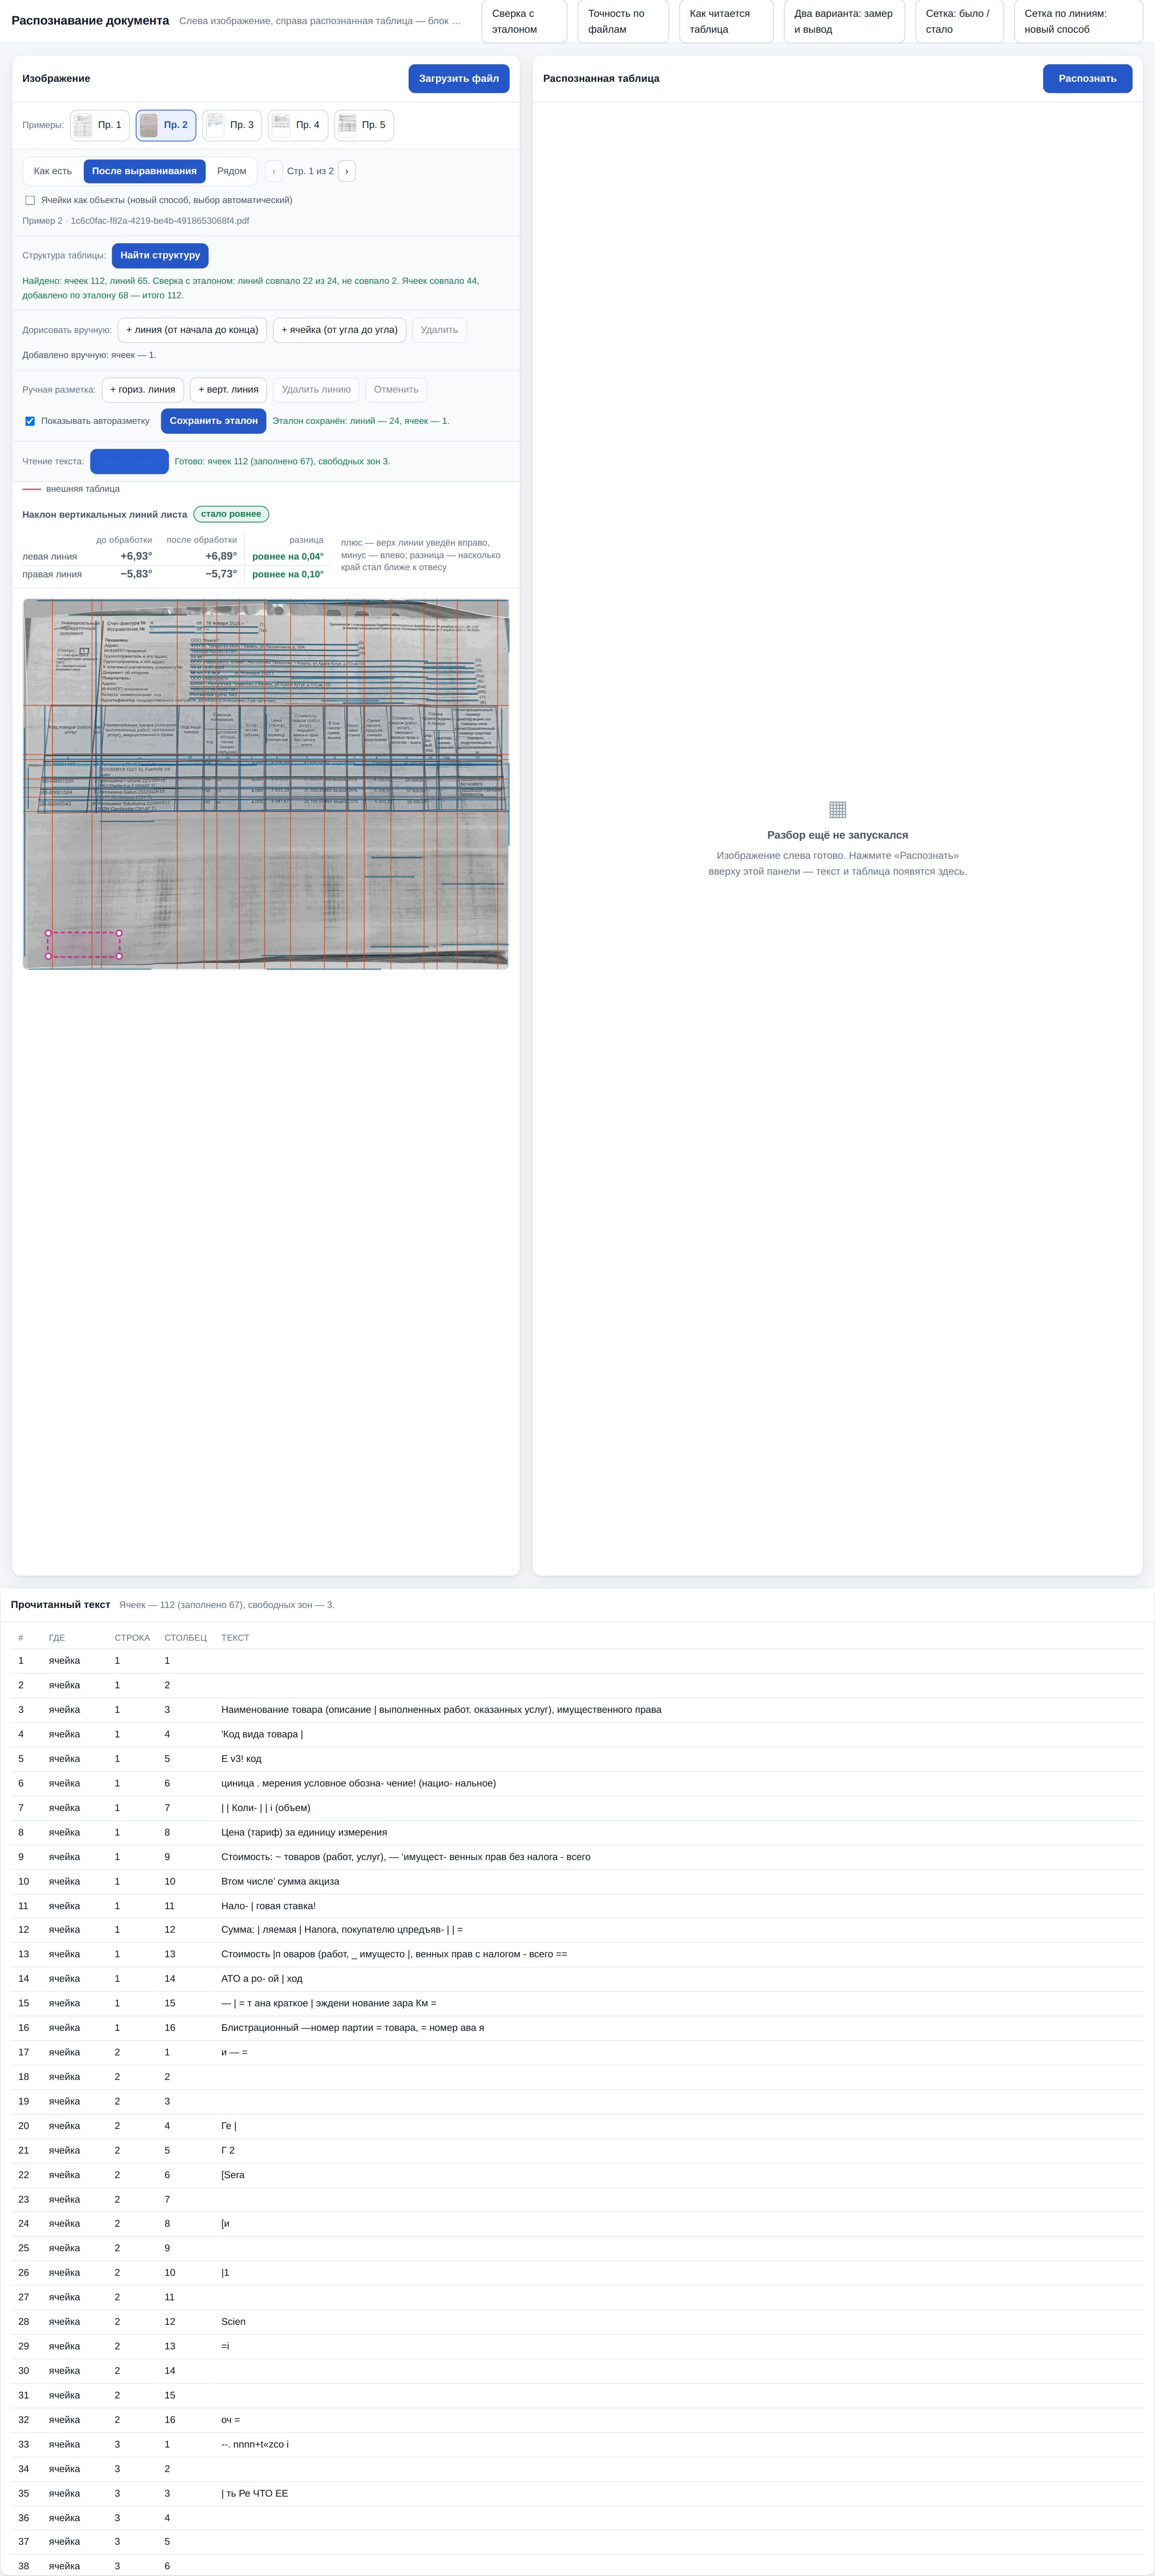
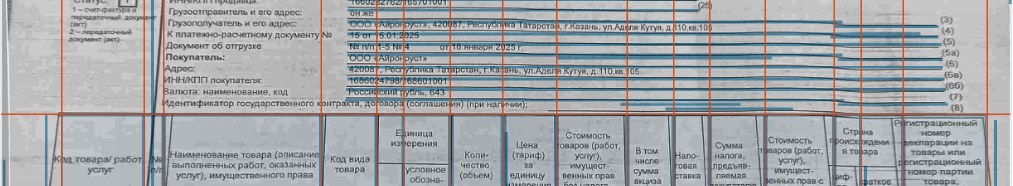
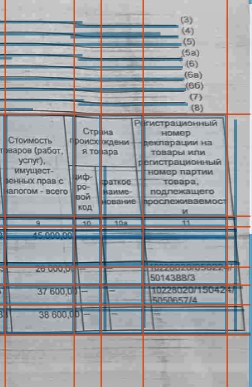
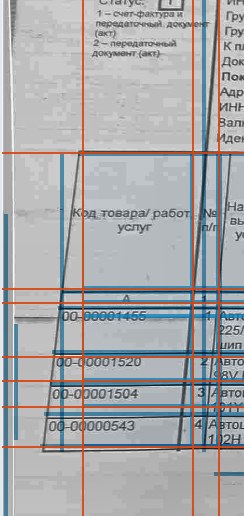
Проверка шла на работающем сервисе, в настоящем браузере, теми же действиями, что делает человек: клики мышью по кнопкам и протяжка мышью по скану. Взят «Пример 2», страница 1, вкладка «После выравнивания». Пройден путь целиком: выбор примера → автоматическое выравнивание → «Найти структуру» → ручная дорисовка мышью → «Сохранить эталон» → повторный автопоиск → «Читать текст». Дополнительно проверено, что у остальных четырёх примеров «Найти структуру» тоже не ломается.
| Шаг пути | Результат |
|---|---|
| Выбрать «Пример 2» кнопкой | Да. Загрузился скан, включилось автоматическое выравнивание. |
| Вкладка «После выравнивания» | Да, переключается и остаётся активной весь сценарий. |
| Кнопка «Найти структуру» | Да. Найдено ячеек — 112, линий — 65. Сверка с ранее сохранённым эталоном: линий совпало 22 из 24, ячеек совпало 44, ещё 68 добавлено по эталону — итого 112. |
| Шапка товарной таблицы размечена ячейками | Да. Все 16 колонок шапки («Код товара/ работ услуг» … «Регистрационный номер декларации») получили свои границы и попали в сетку отдельными ячейками (снимки 2 и 4). Раньше на этом самом примере шапка не размечалась вовсе. |
| Крайний правый столбец на месте | Да. Столбец «11» («Регистрационный номер декларации…») виден в сетке по всей высоте таблицы, правый край сетки доходит до 97% ширины листа (снимок 3). Раньше этот столбец полностью выпадал. |
| Ручная дорисовка мышью («+ ячейка») | Да. Протяжка мышью в свободной зоне листа добавила ячейку, подпись сменилась на «Добавлено вручную: ячеек — 1». |
| «Сохранить эталон» | Да. Подпись «Эталон сохранён: линий — 24, ячеек — 1» — дорисованное вручную вошло в сохранённый эталон. |
| Повторный автопоиск после сохранения | Да, отработал без ошибок, результат тот же (112 ячеек) — новый эталон не разрушил то, что уже находилось само. |
| Кнопка «Читать текст» | Да. Подпись «Готово: ячеек 112 (заполнено 67), свободных зон 3». |
| Многострочный текст в ячейках цел | Да. Проверено на шапке (например, «Наименование товара (описание | выполненных работ. оказанных услуг), имущественного права» — три строки скана слиты в одну запись без потери и без повтора) и на многострочных описаниях товаров. |
| Ошибки на странице / в консоли браузера | Ни одной за весь прогон, от выбора примера до чтения текста. |
| Наблюдение | Пояснение |
|---|---|
| 45 ячеек из 112 в разборе текста пустые | Часть пустых ячеек законна — это правда пустые клетки макета (например, строка «Всего к оплате» занимает не все колонки). Но два конкретных столбца шапки — самый первый («Код товара/ работ услуг») и узкий столбец «№ п/п» — распознаются пустыми во всех строках, хотя на скане текст в них виден глазами (снимок 4): это узкие и слегка скошенные ячейки, движку распознавания текста тяжело их прочитать. Это не про сетку — границы этих ячеек на месте и посчитаны верно; это про качество самого распознавания текста внутри уже правильно найденной ячейки, а движок распознавания в этот шаг менять не входило. |
| Качество текста в узких столбцах шапки низкое | В колонках «Код вида товара», «Условное обозначение (национальное)», «Налоговая ставка» и похожих текст читается с ошибками («циница . мерения» вместо «единица измерения» и т. п.). Причина та же: мелкий повёрнутый шрифт и шум скана — движок распознавания текста не дорабатывался в этом шаге по прямому ограничению задачи. |
| Пример | Результат «Найти структуру» |
|---|---|
| Пример 1 | Найдено: ячеек 266, линий 58. Без ошибок. |
| Пример 3 | Найдено: ячеек 26, линий 61. Без ошибок. |
| Пример 4 | Найдено: ячеек 82, линий 38. Без ошибок. |
| Пример 5 | Найдено: ячеек 306, линий 78. Без ошибок. |
Полный путь (выравнивание → структура → ручная дорисовка → сохранить → повтор → чтение текста) в этой проверке пройден только на «Примере 2» — это и была задача шага. На остальных четырёх — быстрая проверка, что общий шаг «Найти структуру» их не задел.
Весь сценарий на «Примере 2» проходит подряд без единой ошибки, и оба главных требования из прошлых доработок теперь выполняются: шапка размечена отдельными ячейками, а правый столбец таблицы больше не теряется. Ручная дорисовка, сохранение эталона, повторный автопоиск и чтение текста работают как единая цепочка — то, что дорисовано руками, переживает сохранение и попадает в итоговый разбор. Многострочный текст в ячейках цел, задвоений не найдено.
Не идеально — но не про сетку. Два узких столбца шапки читаются с пустым текстом, а несколько других — с шумом в тексте. Это ограничение движка распознавания текста на мелком повёрнутом шрифте, а не задачи по сетке линий и ячеек: доработка самого распознавания в этот шаг не входила по прямому ограничению задания.