Пороги поиска линий: было / стало — «Пример 2», страница 1
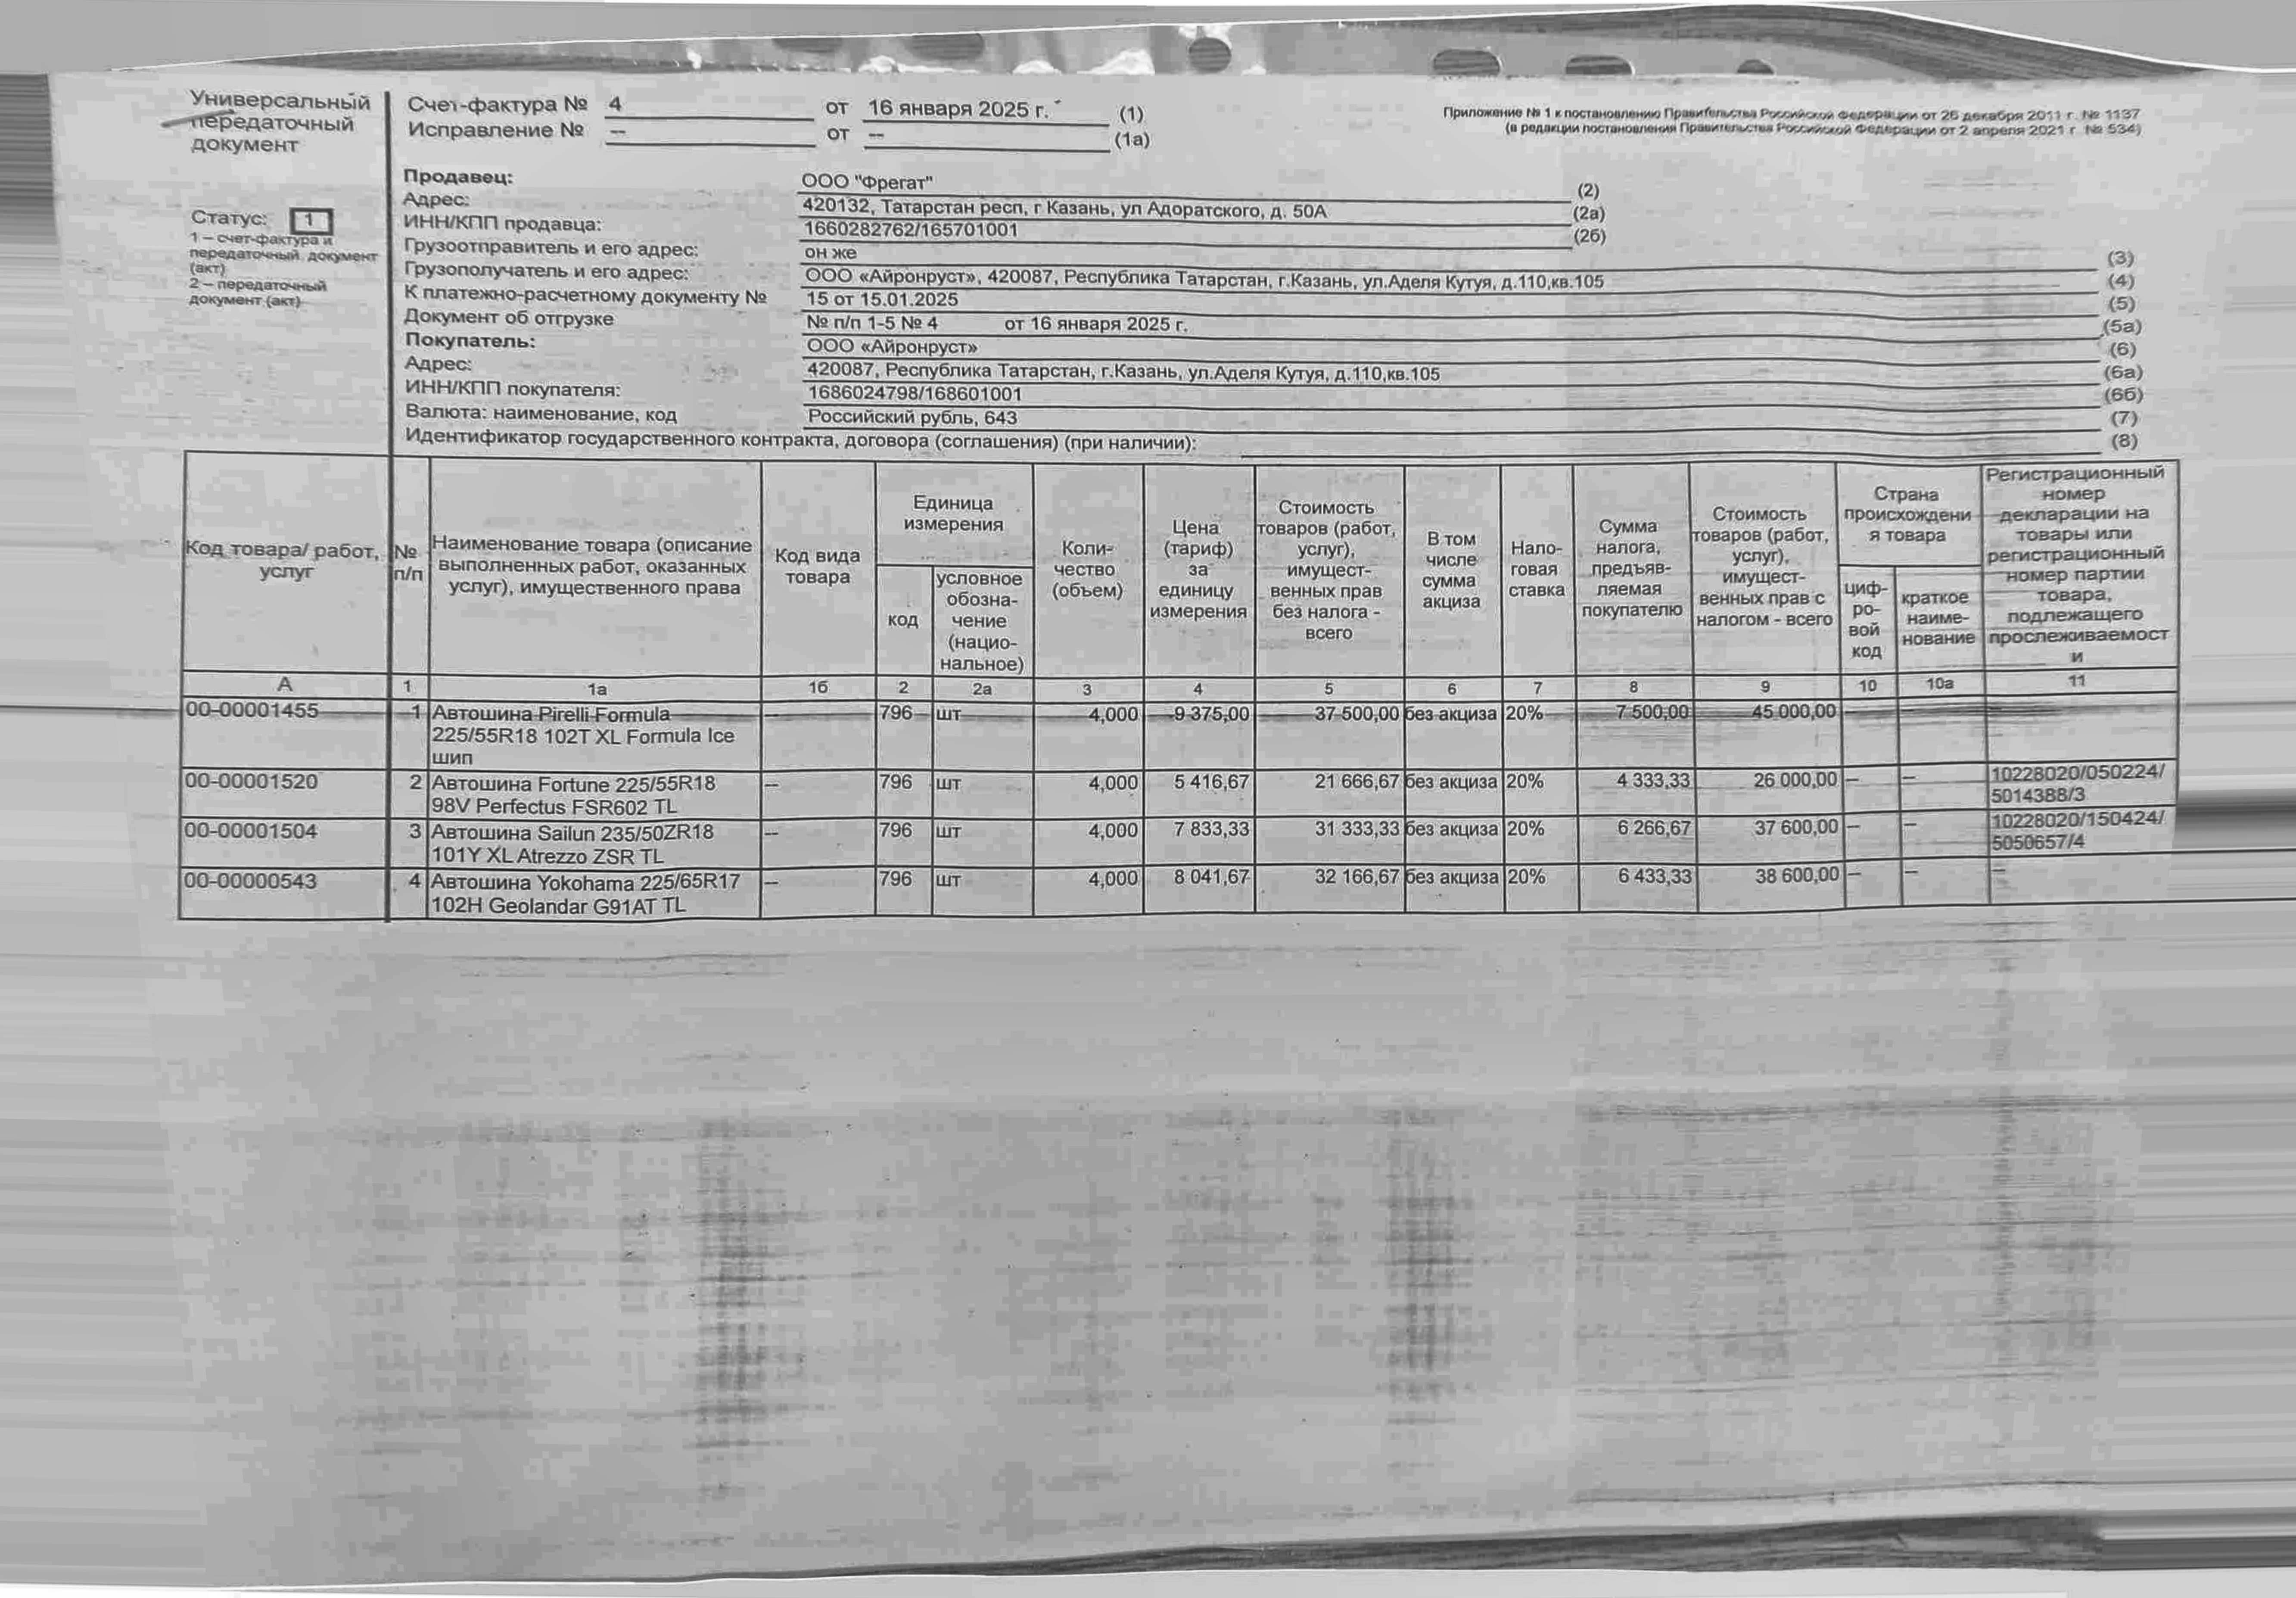
Шаг 5: пороги app/linetable.py (длина полосы, которую морфология
считает линией) подобраны так, чтобы алгоритм ближе совпадал с сохранённым
эталоном (docs/reference-grid/1c6c0fac…-p1.json). Переключатель
ниже показывает то же самое сравнение с эталоном ДО подбора (старый порог,
1/30 стороны картинки) и ПОСЛЕ (новый порог, 1/40) — сейчас в сервисе
работает вариант «после».
Что именно пропущено на выбранном пороге
| Линия эталона | Положение на странице | Зона |
|---|
Почему не 24 из 24 — и что не поддалось подбору
После подбора порога шапка таблицы по-прежнему размечается ячейками полностью (0 пропусков в шапке — было так уже до этого шага) и один из шести пропущенных столбцов правого края («Налоговая ставка») теперь находится. Пять оставшихся столбцов правого края («Сумма налога» … «Регистрационный номер») подбором порога не восстановить: на скане это не отсутствующие, а очень бледные линии — в маске чернил после выравнивания фона больше половины их высоты вообще без следа (проверено по самой картинке, не только по счётчикам). Дальше поднимать порог (пробовали до длины полосы в 1/46 стороны) добавляло уже не настоящие линии эталона, а ложные — на «Примере 3» и «Примере 5» между строк текста внутри одной ячейки появлялась лишняя горизонтальная линия, разрезающая текст пополам. Порог 1/40 — граница, на которой прибавка на этом примере ещё есть, а лишних ячеек на всех пяти примерах заказчика ещё нет.