Распознавание таблиц: что изменилось после доработки
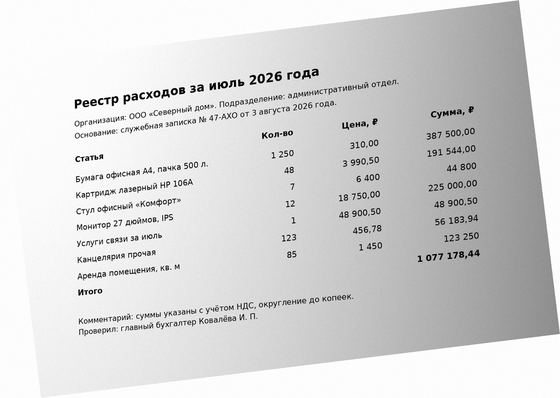
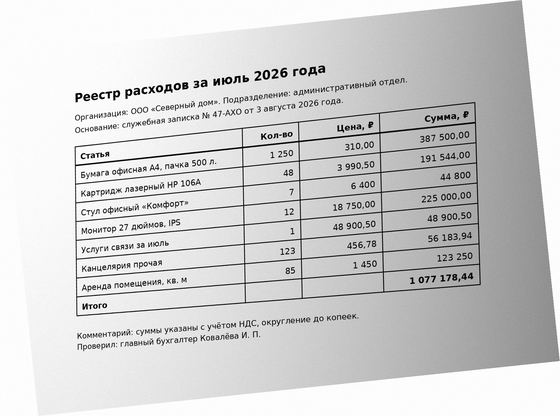
Замер на 12 сканах одной и той же финансовой таблицы: ровные листы, перекос от 5° до 15° в обе стороны, тень от лампы, фото под углом. Эталон известен заранее — 36 ячеек на каждом скане, всего 432. Ячейка засчитана, только если текст совпал полностью.
316 из 432 против 76
368 из 432
Совпадение с эталоном: одно число на отчёт и на приёмку
На документах заказчика: 95,0 % на примере 1 (133 из 140 значений) и 84,5 % по всем пяти документам (278 из 329). Ровно эти же числа показывает приёмка: и отчёт, и страницы приёмки берут их из одного расчёта, своих формул у страниц нет.
- Считаем значения (ячейки) строк товарной таблицы: семь на строку — наименование, количество, цена, стоимость без НДС, сумма НДС, стоимость с НДС, ставка НДС.
- Значение засчитано, если число совпало с эталоном до копейки (пробел между разрядами и запятая вместо точки — не ошибка), наименование совпало не менее чем на 90 % символов, ставка НДС найдена в строке.
- Пропущенная строка считается семью неверными значениями и остаётся в знаменателе: из счёта не выбрасывается ничего.
- Лишние строки на процент не влияют — они показываются отдельным числом.
- Сдвиг строк ошибкой не считается: строки сопоставляются по наименованию и числам. Ошибка — это неверное значение.
- Процент = верные значения ÷ все значения эталона, округление до десятой доли. Итог по набору — по сумме значений, а не среднее из процентов.
Цифры ниже — про другое: это замер на сгенерированных сканах, он показывает, что дала предобработка изображения (было / стало). С совпадением на документах заказчика их сравнивать нельзя: другой набор и другой счёт.
Главное одним взглядом
Ячейки распознаны точно
Ячейки верны по сути (пробелы в разрядах не в счёт)
Строки, где верны все четыре ячейки сразу
Строк целиком верных: было 7 из 108, стало 38.
Кривые сканы — ради них всё и делалось
Из 12 сканов 10 лежат криво: наклон от 5° до 15°. На них таблица находилась 2 раз из 10 — стала находиться 10 из 10.
Верных ячеек на этих сканах: было 46 из 360 (13%), стало 261 из 360 (72%).
Раньше лист доворачивался максимум на 5°, поэтому уже на 8° линии таблицы «размазывались» и страница читалась как сплошной текст — колонок не было вовсе. Сейчас лист выравнивается до 15°, свет выравнивается отдельно, и таблица собирается по найденным границам строк и столбцов.
По каждому скану
| Скан | Таблица | Наклон | Верных ячеек до | Верных ячеек после | Таблица найдена до / после |
|---|---|---|---|---|---|
| Ровный скан, таблица с линиями (контроль) | с линиями | ровно | 28/36 | 26/36 | да / да |
| Скан с перекосом 5°, линии есть | с линиями | 5° | 28/36 | 28/36 | да / да |
| Скан с перекосом 8°, линии есть | с линиями | 8° | 2/36 | 30/36 | нет / да |
| Скан с перекосом 12° в другую сторону | с линиями | 12° | 2/36 | 29/36 | нет / да |
| Скан с перекосом 15° — край диапазона | с линиями | 15° | 2/36 | 29/36 | нет / да |
| Перекос 10° плюс тень от лампы | с линиями | 10° | 2/36 | 29/36 | нет / да |
| Фото под углом, перекос 6°, линии есть | с линиями | 6° | 2/36 | 2/36 | нет / да |
| Ровный скан, таблица без линий (контроль) | без линий | ровно | 2/36 | 29/36 | нет / да |
| Без линий, перекос 5° | без линий | 5° | 2/36 | 29/36 | нет / да |
| Без линий, перекос 10° | без линий | 10° | 2/36 | 29/36 | нет / да |
| Без линий, перекос 15° в другую сторону | без линий | 15° | 2/36 | 28/36 | да / да |
| Фото без линий под углом, перекос 7° | без линий | 7° | 2/36 | 28/36 | нет / да |
«Таблица найдена: нет» означает, что распознавание не увидело таблицу совсем и вернуло текст сплошняком — колонок в результате не было.
Как выглядит результат сейчас
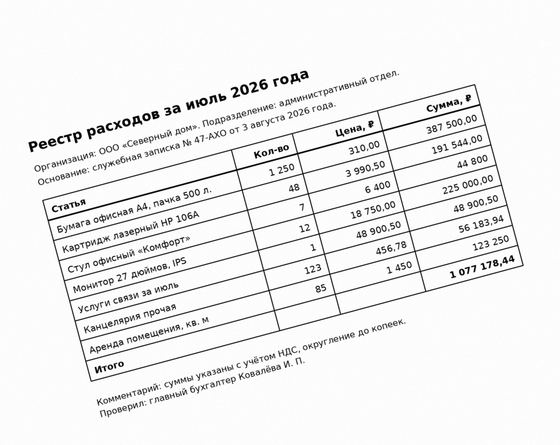
Скан «Скан с перекосом 8°, линии есть». Зелёным — ячейки, совпавшие с эталоном знак в знак, розовым — где есть расхождение.
| Статья | Кол-во | Цена, ? | Сумма, ? |
| Бумага офисная А4, пачка 500 л. | 1250 | 310,00 | 387 500,00 |
| Картридж лазерный НР 106А | 48 | 3 990,50 | 191 544,00 |
| Стул офисный «Комфорт» | 7 | 6 400 | 44 800 |
| Монитор 27 дюймов, IPS | 12 | 18 750,00 | 225 000,00 |
| Услуги связи за июль | 1 | 48 900,50 | 48 900,50 |
| Канцелярия прочая | 123 | 456,78 | 56 183,94 |
| Аренда помещения, кв. м | 85 | 1450 | 123 250 |
| Итого | 1077 178,44 |
Видно, что расхождения — это не перепутанные колонки, а мелочи внутри ячейки: знак рубля в шапке, пробел между разрядами, латинская «HP» прочитана как русская «НР». Сумма и количество стоят каждая в своей колонке. Сдвига значений между колонками нет ни на одном из 12 сканов (было 0 строк со сдвигом, стало 0).
Что мерили
Где по-прежнему плохо
Один случай из 12 доработка не вытянула: «Фото под углом, перекос 6°, линии есть». Перспектива и наклон вместе искривляют нарисованную сетку так, что границы колонок не находятся, и часть значений слипается в одну ячейку. На таком кадре результат нужно править руками на экране проверки.
Практический вывод: фотографировать документ лучше сверху, без сильного ракурса. Скан с перекосом до 15° читается нормально, фото под углом с нарисованной сеткой — нет.
Точности хватает?
Для финансового документа — нет, если проверять результат некому. 73% точных ячеек означает, что примерно каждая четвёртая ячейка требует взгляда человека. В деньгах ошибка в одной цифре стоит дороже, чем время на проверку, поэтому экран проверки (слева скан, справа таблица по ячейкам, клик — правка) — не дополнение, а обязательная часть работы.
Обработка одного скана занимает около 8.4 секунды.
Попробовать самому
Загрузите скан или PDF — получите таблицу, экран проверки и файлы Markdown / JSON.
Два варианта распознавания на пяти документах — сравнение, цифры по качеству, скорости и весу, принятое решение и почему (там же — ссылка на подробности замера).
Как читается таблица — сначала находится сетка строк и столбцов, потом содержимое клетка за клеткой; числа и даты после распознавания приводятся к единому виду (там же — сколько значений уехало в чужую колонку раньше и сейчас).
Как текст режется по найденным линейкам — по строкам: соседние строки таблицы больше не попадают в один блок (прогон по всем пяти документам, «до / после») и по столбцам: соседние клетки бланка.
Сетка таблицы прямо на скане, на экране «Проверить и исправить» — прогон по всем пяти документам: линии совпадают с границами ячеек, щелчок по скану подсвечивает значение справа (со снимками экрана, включая перекошенный пример).
Что с сеткой сегодня и первый уровень вложенности — где сетка врёт на пяти документах и как внутри ячейки показывается её собственная мини-таблица (со снимками экрана).
Вложенность на любую глубину — проверка на рабочей ссылке: что видно на «Примере 2», сколько уровней на ваших бланках и как разбор берёт три уровня подряд (со снимком экрана и списком ограничителей, чтобы спуск не ушёл по кругу).
Слабые и перекошенные сканы — бледные и порванные линейки находятся, при перекосе сетка не рассыпается: «было / стало» на всех пяти документах и на перекошенном примере.
Какая линия что означает — внешняя таблица и разбивка внутри ячейки отличаются толщиной, цветом и штрихом, под переключателем есть подпись; там же — сверка, что линии не затирают текст скана.
Приёмка сетки на всех пяти примерах — каждый документ открыт на рабочей ссылке, сетка сверена с линейками бланка глазами: где совпало, где осталось расхождение и почему, плюс проверка, что клик по ячейке и разметка не сломались.
Где на выпрямленной странице проходят линейки таблицы — линии строк, найденные на всех пяти документах и границы столбцов: настоящий скан с нанесёнными линиями.
Замер точности по каждому файлу — сколько значений прочитано верно и что именно ломается.
Что даёт подготовка снимка перед чтением — один и тот же файл без подготовки и с подготовкой, рост по каждому файлу.
Тестовый набор из пяти ваших документов (скан + эталонный разбор к каждому) — список примеров, пояснение к формату эталона — что означает каждое поле.
Сверка с эталоном по каждому файлу — эталон и что распозналось, рядом, с подсветкой расхождений (там же процент верных значений до и после доработок).
Ручная разметка линий и сверка с автоматической сеткой — приёмка мышью на работающем сервисе: нарисовать линию, удалить, передвинуть, сохранить и увидеть её после перезагрузки; там же — крупные снимки шапки и правого края «Примера 2».
Приёмка всего пути на «Примере 2» — выбор примера, автовыравнивание, поиск структуры, ручная дорисовка, сохранение эталона, повторный автопоиск и чтение текста подряд: шапка и правый столбец теперь размечены ячейками, что осталось слабым местом — тоже там.
Как весь путь прошли на приёмке — отчёт о проверке со скриншотами.
Почему переход к блоку иногда не подсвечивает кусок скана — разбор на живом сайте: где именно обрывается связь.
Где текст склеивается из двух соседних столбцов — прогон пяти примеров: сколько таких блоков в каждом документе и что происходит с документом, снятым под углом.
Проверка глазами на экране распознавания — все пять документов по очереди: блок справа и его область на скане, отдельно документ с перекосом, снимки экрана.